概述
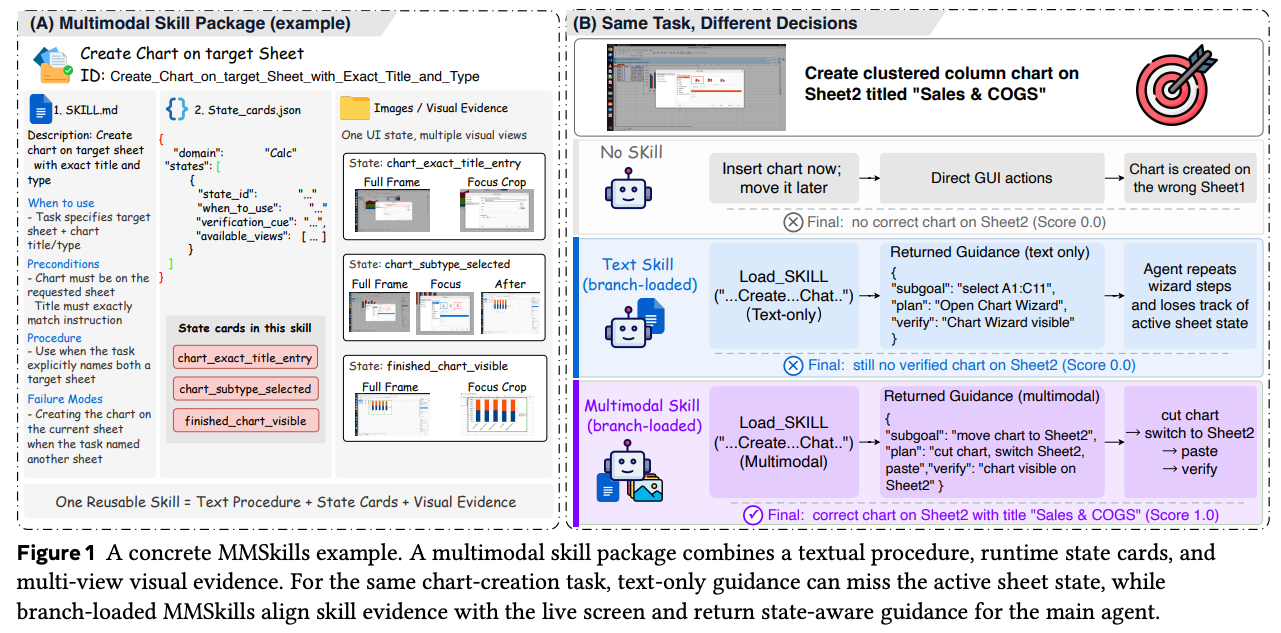
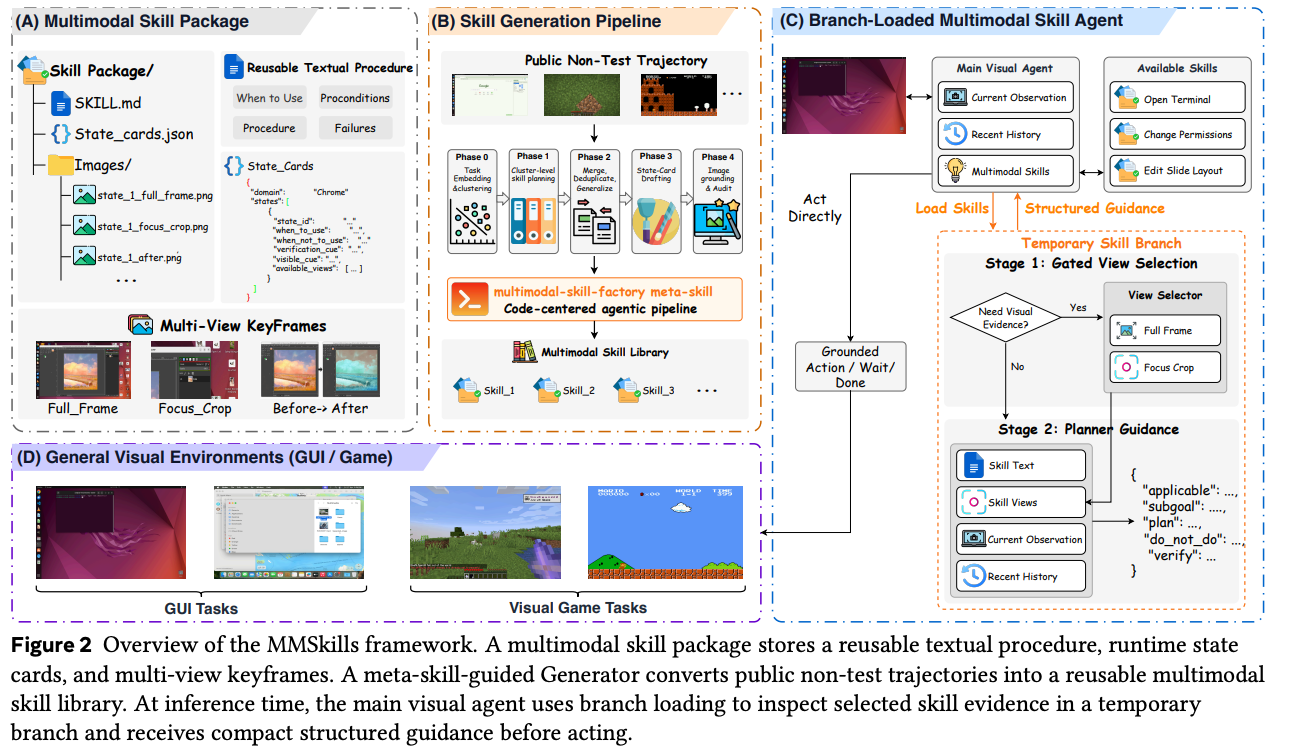
MMSkills 提出了一套**多模态技能包(Multimodal Skill Package)**框架,用于为视觉 Agent 提供可复用的程序性知识。核心思路是将公开的 Agent 交互轨迹转化为结构化技能包,在推理时以”分支加载”方式注入视觉证据,避免主 Agent 上下文膨胀。
- 论文:ArXiv 2605.13527(2026-05)
- 代码:DeepExperience/MMSkills(130 stars,Python,651MB)
- 作者:Kangning Zhang, Shuai Shao, Qingyao Li, Jianghao Lin, Lingyue Fu, Shijian Wang, Wenxiang Jiao, Yuan Lu, Weiwen Liu, Weinan Zhang, Yong Yu
核心问题
论文聚焦三个挑战:
- 技能包应包含什么:多模态程序性知识如何结构化表示
- 技能包从哪里来:如何从公开的非评估轨迹中自动生成
- 推理时如何使用:如何在不撑爆图像上下文的前提下让 Agent 参考视觉证据
方法
多模态技能包结构
每个技能包包含三部分:
- 文本程序(Textual Procedure):步骤化的操作指令
- 运行时状态卡(Runtime State Cards):关键状态的截图/视觉快照
- 多视角关键帧(Multi-view Keyframes):操作过程中的视觉锚点
轨迹转技能生成器(Trajectory-to-Skill Generator)
将公开 Agent 交互轨迹转化为技能包的流水线:
- 工作流分组(Workflow Grouping):将轨迹按任务阶段切分
- 程序归纳(Procedure Induction):从轨迹中提炼文本步骤
- 视觉接地(Visual Grounding):将步骤与关键帧对齐
- 元技能审计(Meta-skill-guided Auditing):用元技能校验生成质量
分支加载多模态技能 Agent(Branch-loaded Skill Agent)
推理时的核心机制:
- 在临时分支中加载状态卡和关键帧
- 将视觉证据与当前环境状态对齐
- 将对齐结果蒸馏为结构化指导传给主 Agent
- 主 Agent 不直接处理大量图像,避免上下文爆炸
实验结果
- 在 GUI 和游戏类视觉 Agent 基准上评估
- 对前沿大模型和小模型均有提升
- 具体数字见论文
与 Wiki 已有内容的关联
- agentmemory — 同样关注 Agent 跨会话知识复用,但侧重记忆检索而非技能包
- 2604.14228_dive-into-claude-code — Claude Code 的技能(Skill)机制与本文的技能包概念有对应关系