一句话定位: 训练无关(training-free)的多 Agent 递归自我改进框架——由 Curriculum / Actor / Verifier 三个 Agent 在全新数字环境中自主探索、让「探索所得」与「实际执行结果」对齐,并把可复用知识沉淀进持久 memory;测试期冻结 memory 直接复用,全程不改动模型参数。
GitHub: AetherLabsAI/RSIAgent Stars: 524 | Forks: 59 | License: Apache-2.0 | Language: Python | 创建: 2026-09-13 论文: arXiv:2609.15364(v1 2026-09-14,v2 2026-09-18,50 页;HF Daily Papers 2026-09-15 第 6 名) 作者: Sibo Zhu, Shicheng Fan, Xinyue Wang, Wenyi Wu, Kun Zhou, Biwei Huang 配套项目: RSIGame(arXiv:2609.39045,把同一套 RSI 思路延伸到自主游戏开发)
为什么值得关注
- RSI 的「不动权重」落地路线:与 sia 的 Harness+权重双向更新不同,RSIAgent 把自我改进完全落在持久 memory 构建上,模型参数全程固定,规避了权重微调的工程与安全成本
- broad-then-deep 探索策略:先并行广撒网获取多样经验(BRS),再对硬案例/隐藏约束/边界条件做聚焦深挖(DRS),最后冻结 memory 供下游任务复用
- 验证与执行强隔离:Verifier Agent 看不到 Actor 的私有推理与 memory,只检查真实环境状态;benchmark 官方 grader 在学习循环内结构上不可达(sealed grader),只有循环返回后由宿主调用一次
- 不对称交叉验证:主路径 Actor=GLM-5.3 / Verifier=Kimi K3,升级路径交换角色(Kimi Actor ↔ GLM Verifier),用异构模型降低同源偏差
- 工程纪律可审查:把 Actor/Charter 等 prompt 面标为「Constraint #0 审计面」,配
test_no_leakage.py+ 黑名单扫描防 benchmark 任务/grader 泄漏进 prompt,并有 wave memory barrier、memory 快照 SHA-256、可回滚候选人镜像等硬约束 - 提升强开源模型:论文称让 Kimi-K3 与 GLM-5.3 在 OSWorld-v2、Agent’s Last Exam 上超过 GPT-6 等前沿闭源模型
三个 Agent 的角色分工
| 角色 | 输入与权限 |
|---|---|
| Curriculum Agent | 依据历史结果与累积知识挑选有信息量的探索任务、决定是否继续练习;只看学习进度,不评判候选结果、也不撰写 Actor 的 memory |
| Actor Agent | 通过可执行的 Python / Bash 程序 + 视觉观测操作软件;经过验证后,同一个 Actor Agent 把自己经验蒸馏并与既有 memory 合并 |
| Verifier Agent | 独立检查任务要求与结果环境,反馈用于「落地」学习;不能读取 Actor 的私有推理或 memory,其 guest 内改动会在 Actor 恢复前回滚 |
| Host harness | 强制隔离、记录 artifact、在合法边界提交 memory、调用封装的官方评测器 |
三阶段运行时(对应论文 BRS → DRS → 复用)
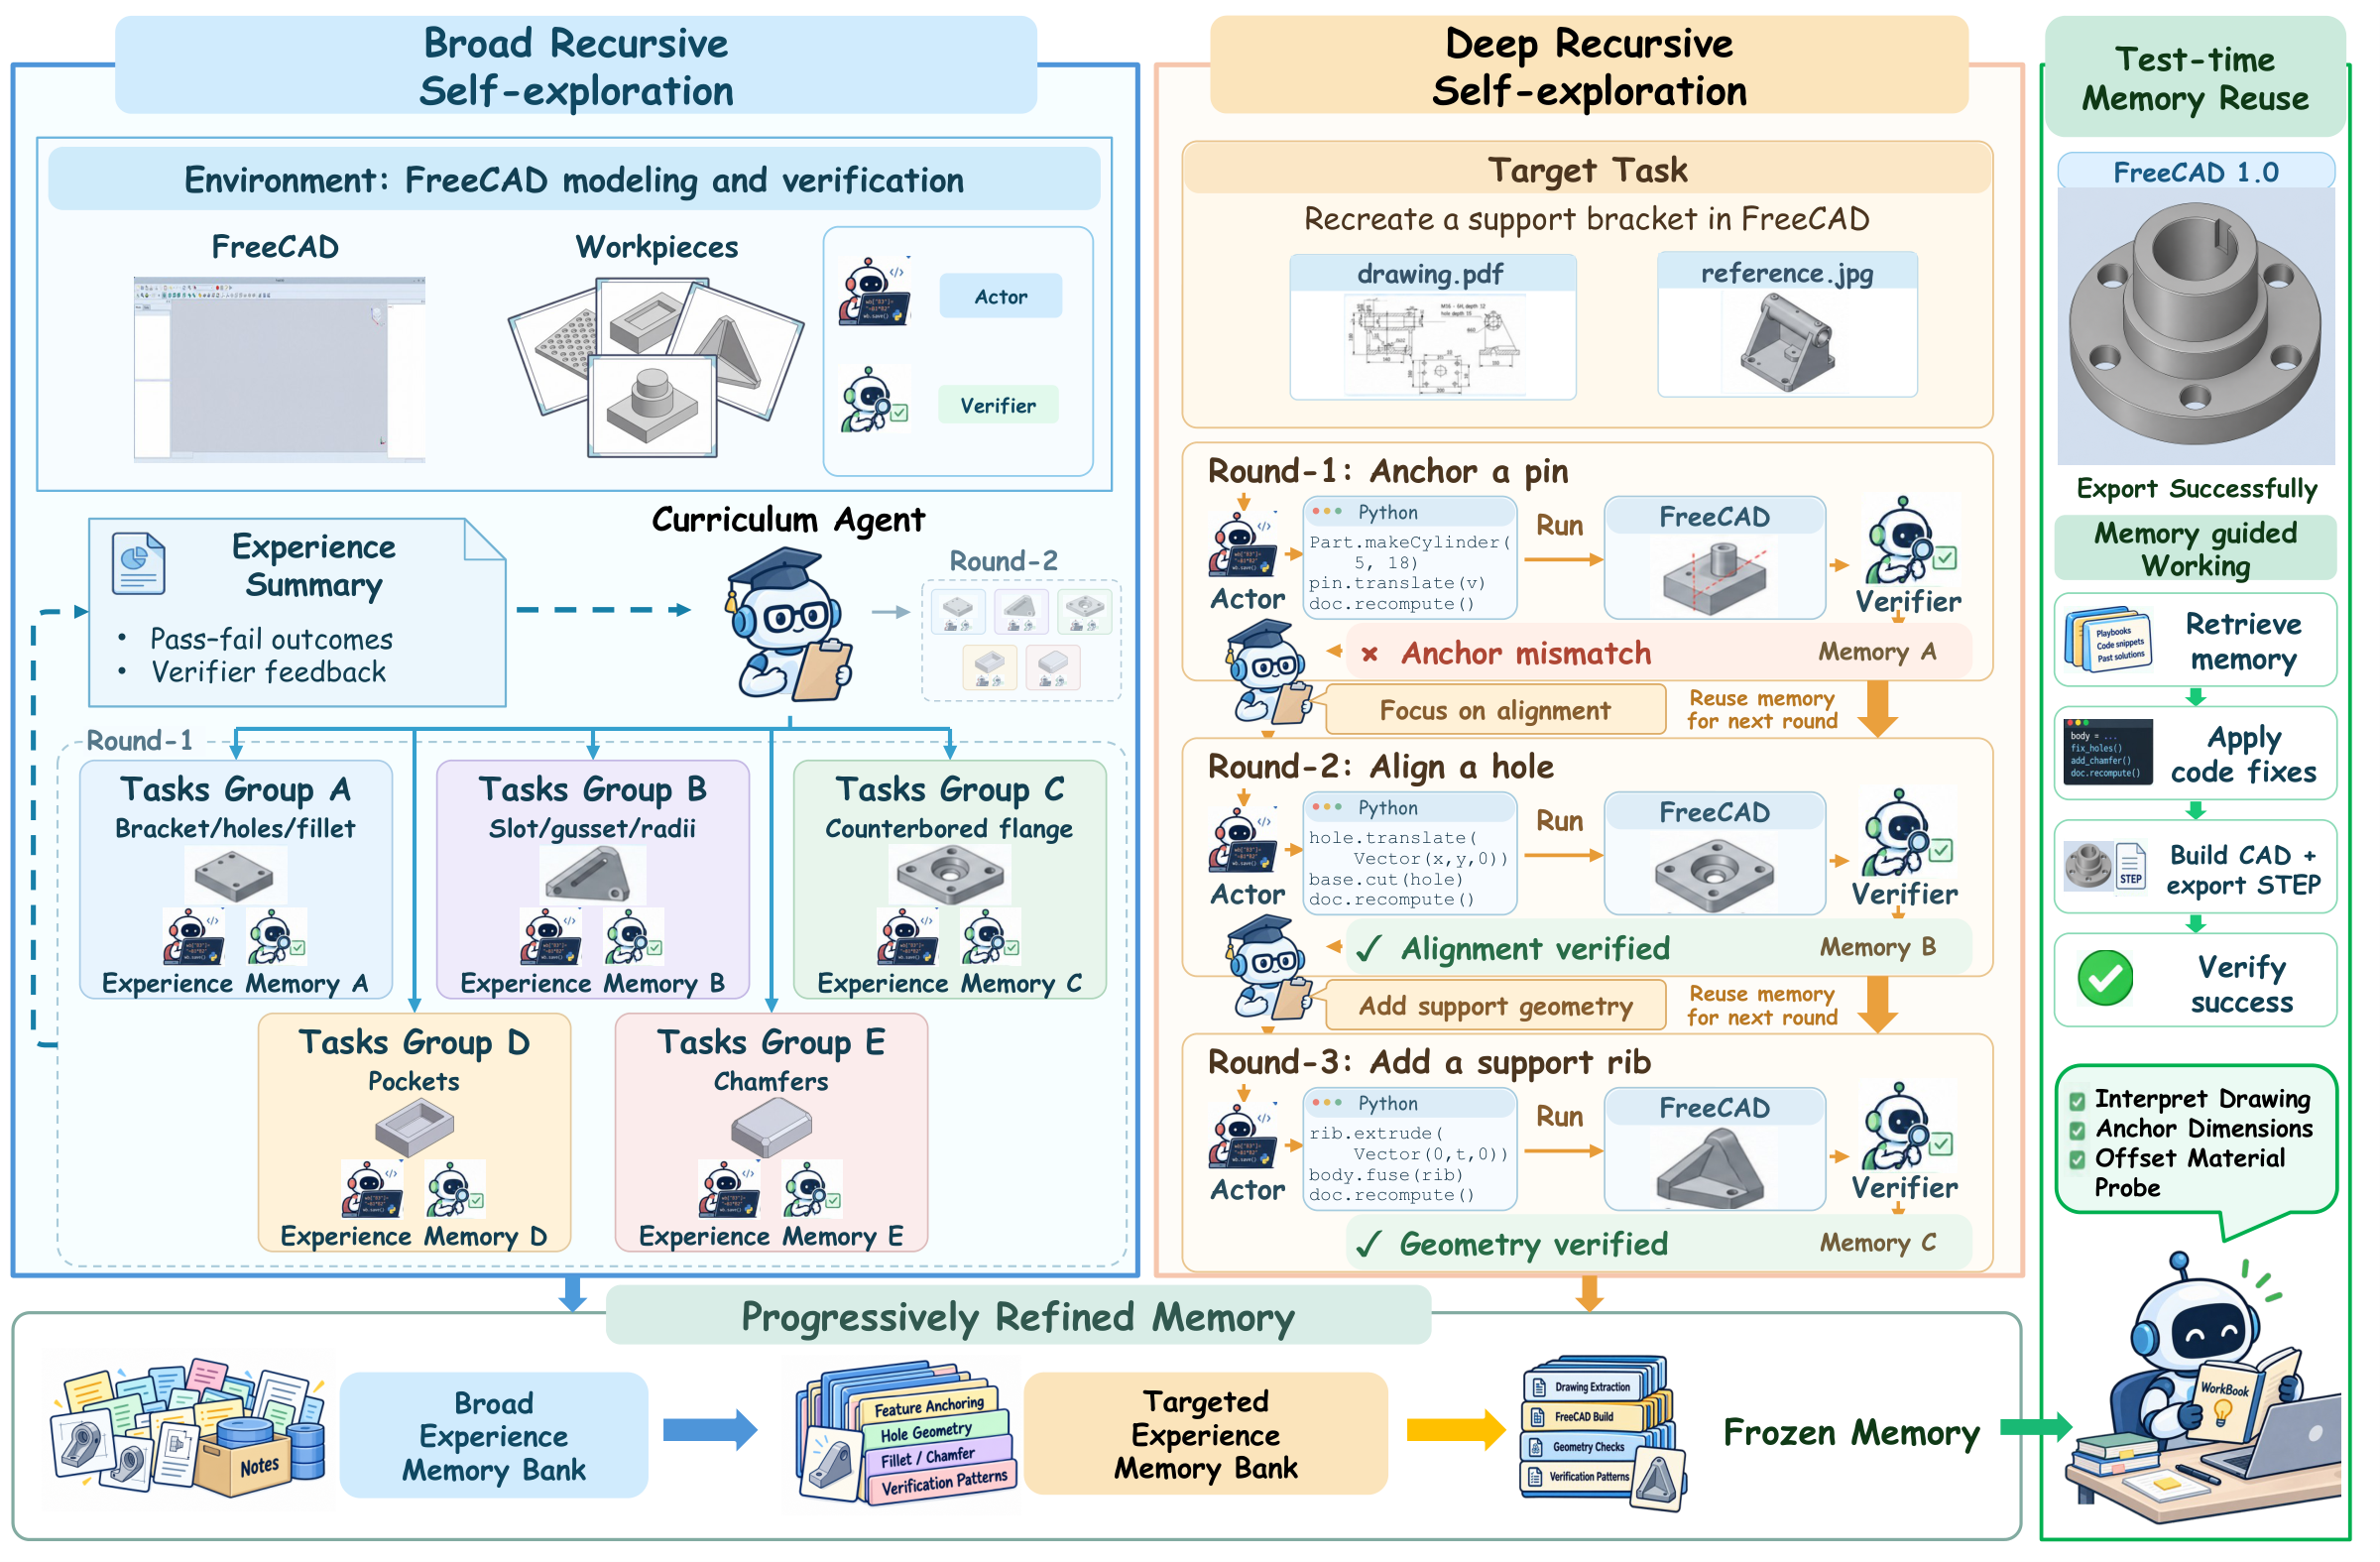
论文 Figure 1(官方原图,2400×1575):broad-then-deep 框架全景,以 FreeCAD 任务为例——并行广探得到的经验逐步收敛为针对性 memory,最后冻结复用。
| 运行时阶段 | 论文阶段 | 学习与执行 |
|---|---|---|
| Phase 1 | Broad Recursive Self-exploration (BRS) | Curriculum 编写一批练习项目,各分支从同一份 pre-wave memory 快照出发并行执行并各自获得 Verifier 判定;全波完成有效验证后才按编写顺序串行蒸馏经验。未完成/隔离的分支会阻塞整波,且其未发布 memory 不合并 |
| Phase 2 | Deep Recursive Self-exploration (DRS) | 先做一次真实目标尝试,暴露 gap 与脆弱成功;Curriculum 选定聚焦练习,每个已验证经验在下次练习/目标尝试之前就更新 memory |
| Phase 3 | Test-time memory reuse | Actor 在冻结 memory 下执行任务,与 Verifier 走与 RSI 相同的 action–verification 循环;交互结束后才由官方评测器打分,评测输出不能回流进任何学习阶段 |
两条停止策略:curriculum_review(默认,即使 target PASS 也允许 Curriculum 再审查一次「值不值得多练习」)与 verifier_pass(target PASS 即停)。STALLED / 预算退出与「成功收敛」被刻意区分,基础设施错误永不被映射成 PASS/FAIL。
关键工程机制
- Memory 即学习状态:跨任务持久;每次独立尝试会重置交互历史与任务环境,但 Agent 框架不变。
explore/memory_hash.py用规范 JSON 的 SHA-256 给不可变快照做内容哈希(canonical_sha256/tree_sha256) - Wave memory barrier:并行分支共享起点、串行提交,避免并发写 memory 产生竞态
- 候选人回滚镜像:Verifier 在 rollback-protected mirror 上审查,
verifier_execution_mode: rollback_mirror;共享的远程可变服务无法回滚,需用独立账号或串行化 - 视觉观测:Actor 本身可以是 text-primary,「看」的动作委派给原生视觉模型(Kimi K3),图像字节以基础形式无损保留在内部 transcript,跨轮次/进程恢复拿到同一观测
- 封装的官方 grader:
core/loop.py只接收指令字符串与 VM handle,benchmark grader 在该函数返回后才被调用一次,保证「正式分数位于学习循环之外」
基准结果(论文报告的 mean partial-credit %)
| 基准与口径 | RSIAgent w/o RSI | RSIAgent | Full-credit w/o → with |
|---|---|---|---|
| OSWorld 2.0 · 0808 offline · 82 tasks | 71.97 | 78.98 | 37.80 → 42.68 |
| Agents’ Last Exam · Near-term · 67 tasks | 83.75 | 84.82 | 49.25 → 50.75 |
口径须知:聚合非「匹配重复运行的平均」。OSWorld 的 RSI 列使用 41 条已录 RSI 条目、其余 41 任务沿用 baseline;ALE 用 19 条 RSI 列条目、其余 48 沿用 baseline,且含本地重评与协议变体。这是手稿报告结果,不是本 release 的 matched-protocol 榜单提交。
论文的 failure analysis 指出改进的三个上限:练习可能错过真正的弱点、验证可能接受不完整产物、memory 可能固化错误规则——所以探索质量、验证质量、记忆巩固质量与练习量同样重要。
案例实录(官方 demo 预览)
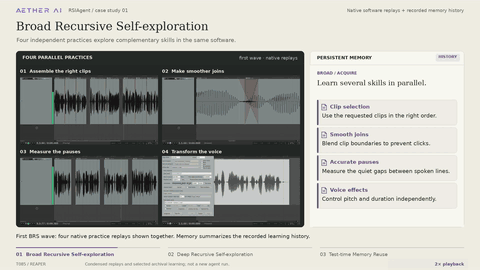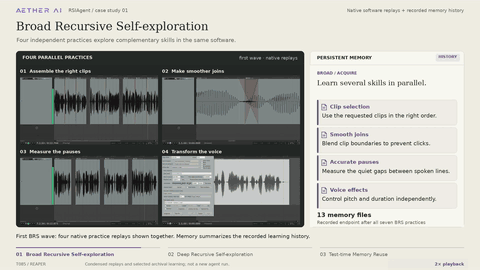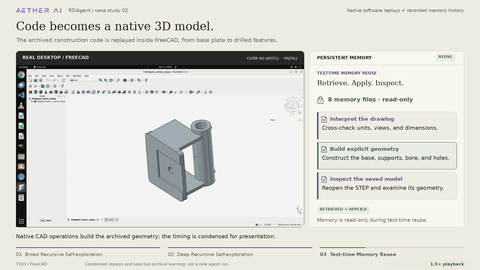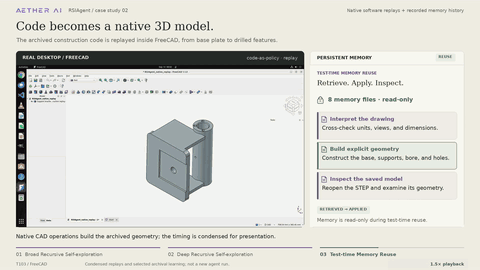
官方 case-studies 预览动画。两个真实案例:REAPER 音频制作(T085)——组装电台 bumper,要求保留给定源片段顺序、插入精确间隙、输出单独处理的结尾;广探阶段并行铺开源选择/精确拼接/静音测量/音高与时长变换,深挖阶段发现「预拼音频 vs 原生编辑」的采样不一致,据此修正 memory 里的重采样建议(
RENDER_RESAMPLE 0 0 0),最终 68.00 → 94.17。FreeCAD 3D 建模——探索阶段观察到的 FreeCAD 生成动作被固化成 memory 里的原生工作流,第二次尝试直接复现(“Code becomes a native 3D model”)。动画中的11 → 13 → 17 memory files即 BRS → DRS → 冻结复用三阶段的 memory 增长。
仓库结构
run_osworld.py / run_ale.py   # 两个 benchmark 入口
core/                         # 共享 Actor + Verifier 运行时(loop/actor/verifier/self_evolving_loop)
explore/                      # Curriculum、memory、provisioning、recovery(含 phase1_wave/practice_loop/charter)
benchmarks/osworld|ale/       # 各 benchmark 的 stage/VM adapter/evaluation
env/                          # guest transport 与隔离(vm/rollback/verifier_control)
llm/                          # OpenRouter 模型客户端(多模态无损历史)
config/roles/*.yaml           # Actor/Verifier/Curriculum 角色 profile
tests/                        # 54 个回归测试文件
docs/                         # ARCHITECTURE / OPERATIONS / PAPER / RELEASE 等
tools/                        # 准备、smoke、release 校验、恢复工具
快速上手
git clone https://github.com/AetherLabsAI/RSIAgent.git
cd RSIAgent
cp .env.example .env          # 填 OPENROUTER_API_KEY

# 不需要凭证/Docker 的可移植校验
uv venv .venv --python 3.12
uv pip install --python .venv/bin/python -r requirements-dev.txt
.venv/bin/python tools/check_rsi_release.py运行基准的环境要求:Python 3.12 + uv、Linux 主机 + Docker + /dev/kvm、官方 guest 镜像与 benchmark 资源(OSWorld-V2 pinned release、ALE 分别约 167 GiB Linux / 157 GiB Windows 镜像)。运行入口 run_osworld.py --arm {baseline|rsi|both} 与 run_ale.py run,示例协议在 config/osworld/rsi.example.json,开始建议 --concurrency 1。
相关页面
- recursive-self-improvement — RSI 的判据与证据地图;RSIAgent 是「窄域闭环 + 可自动评分 + 评估在更新边界外」三条件的完整工程样例
- sia — 另一条 Self-Improving 路线(Meta/Target/Feedback 三 Agent,更新 Harness 与权重)
- darwin-godel-machine — 用基准实证替代形式化证明的 DGM,RSI 证据链里的同类机制
- prime-agent — Continual Harness「状态账本 + 小步可回滚」的自进化工程路线
- agent-continual-learning — Agent 持续学习三层框架(Model/Harness/Context),memory 构建的定位参照
- agent-harness-anatomy / meta-harness — Harness 解剖与自动优化框架
- agent-skill-self-update — Skill 自更新机制的对照方向
资源
- GitHub: https://github.com/AetherLabsAI/RSIAgent
- 项目主页: https://aetherlabsai.github.io/RSIAgent/
- 论文: https://arxiv.org/abs/2609.15364
- 配套项目 RSIGame: https://github.com/WenyiWU0111/RSIGame
- 架构文档:
docs/ARCHITECTURE.md(角色接口 / wave memory barrier / 停止规则) - 运维与恢复:
docs/OPERATIONS.md - 论文口径说明:
docs/PAPER.md